
Dienste
Früher oder später braucht fast jedes Projekt mehr als eine Datenbank: einen Cache, einen Ort, an dem Testmails landen, eine Queue, eine Suchmaschine. Envoryx betreibt so etwas als optionale Dienste neben deinem Projekt. Jeder bekommt einen eigenen Container im Projektnetz, legt seine Daten - falls er welche hat - in einem Volume ab und sagt deiner Anwendung über Umgebungsvariablen, wo er zu finden ist.
Dienste fügst du im Assistenten im Schritt Projekt & Dienste hinzu oder später im Bereich Dienste. Wenn du einen Dienst mit Daten entfernst, fragt Envoryx, was mit den Daten passieren soll; mehr dazu weiter unten.
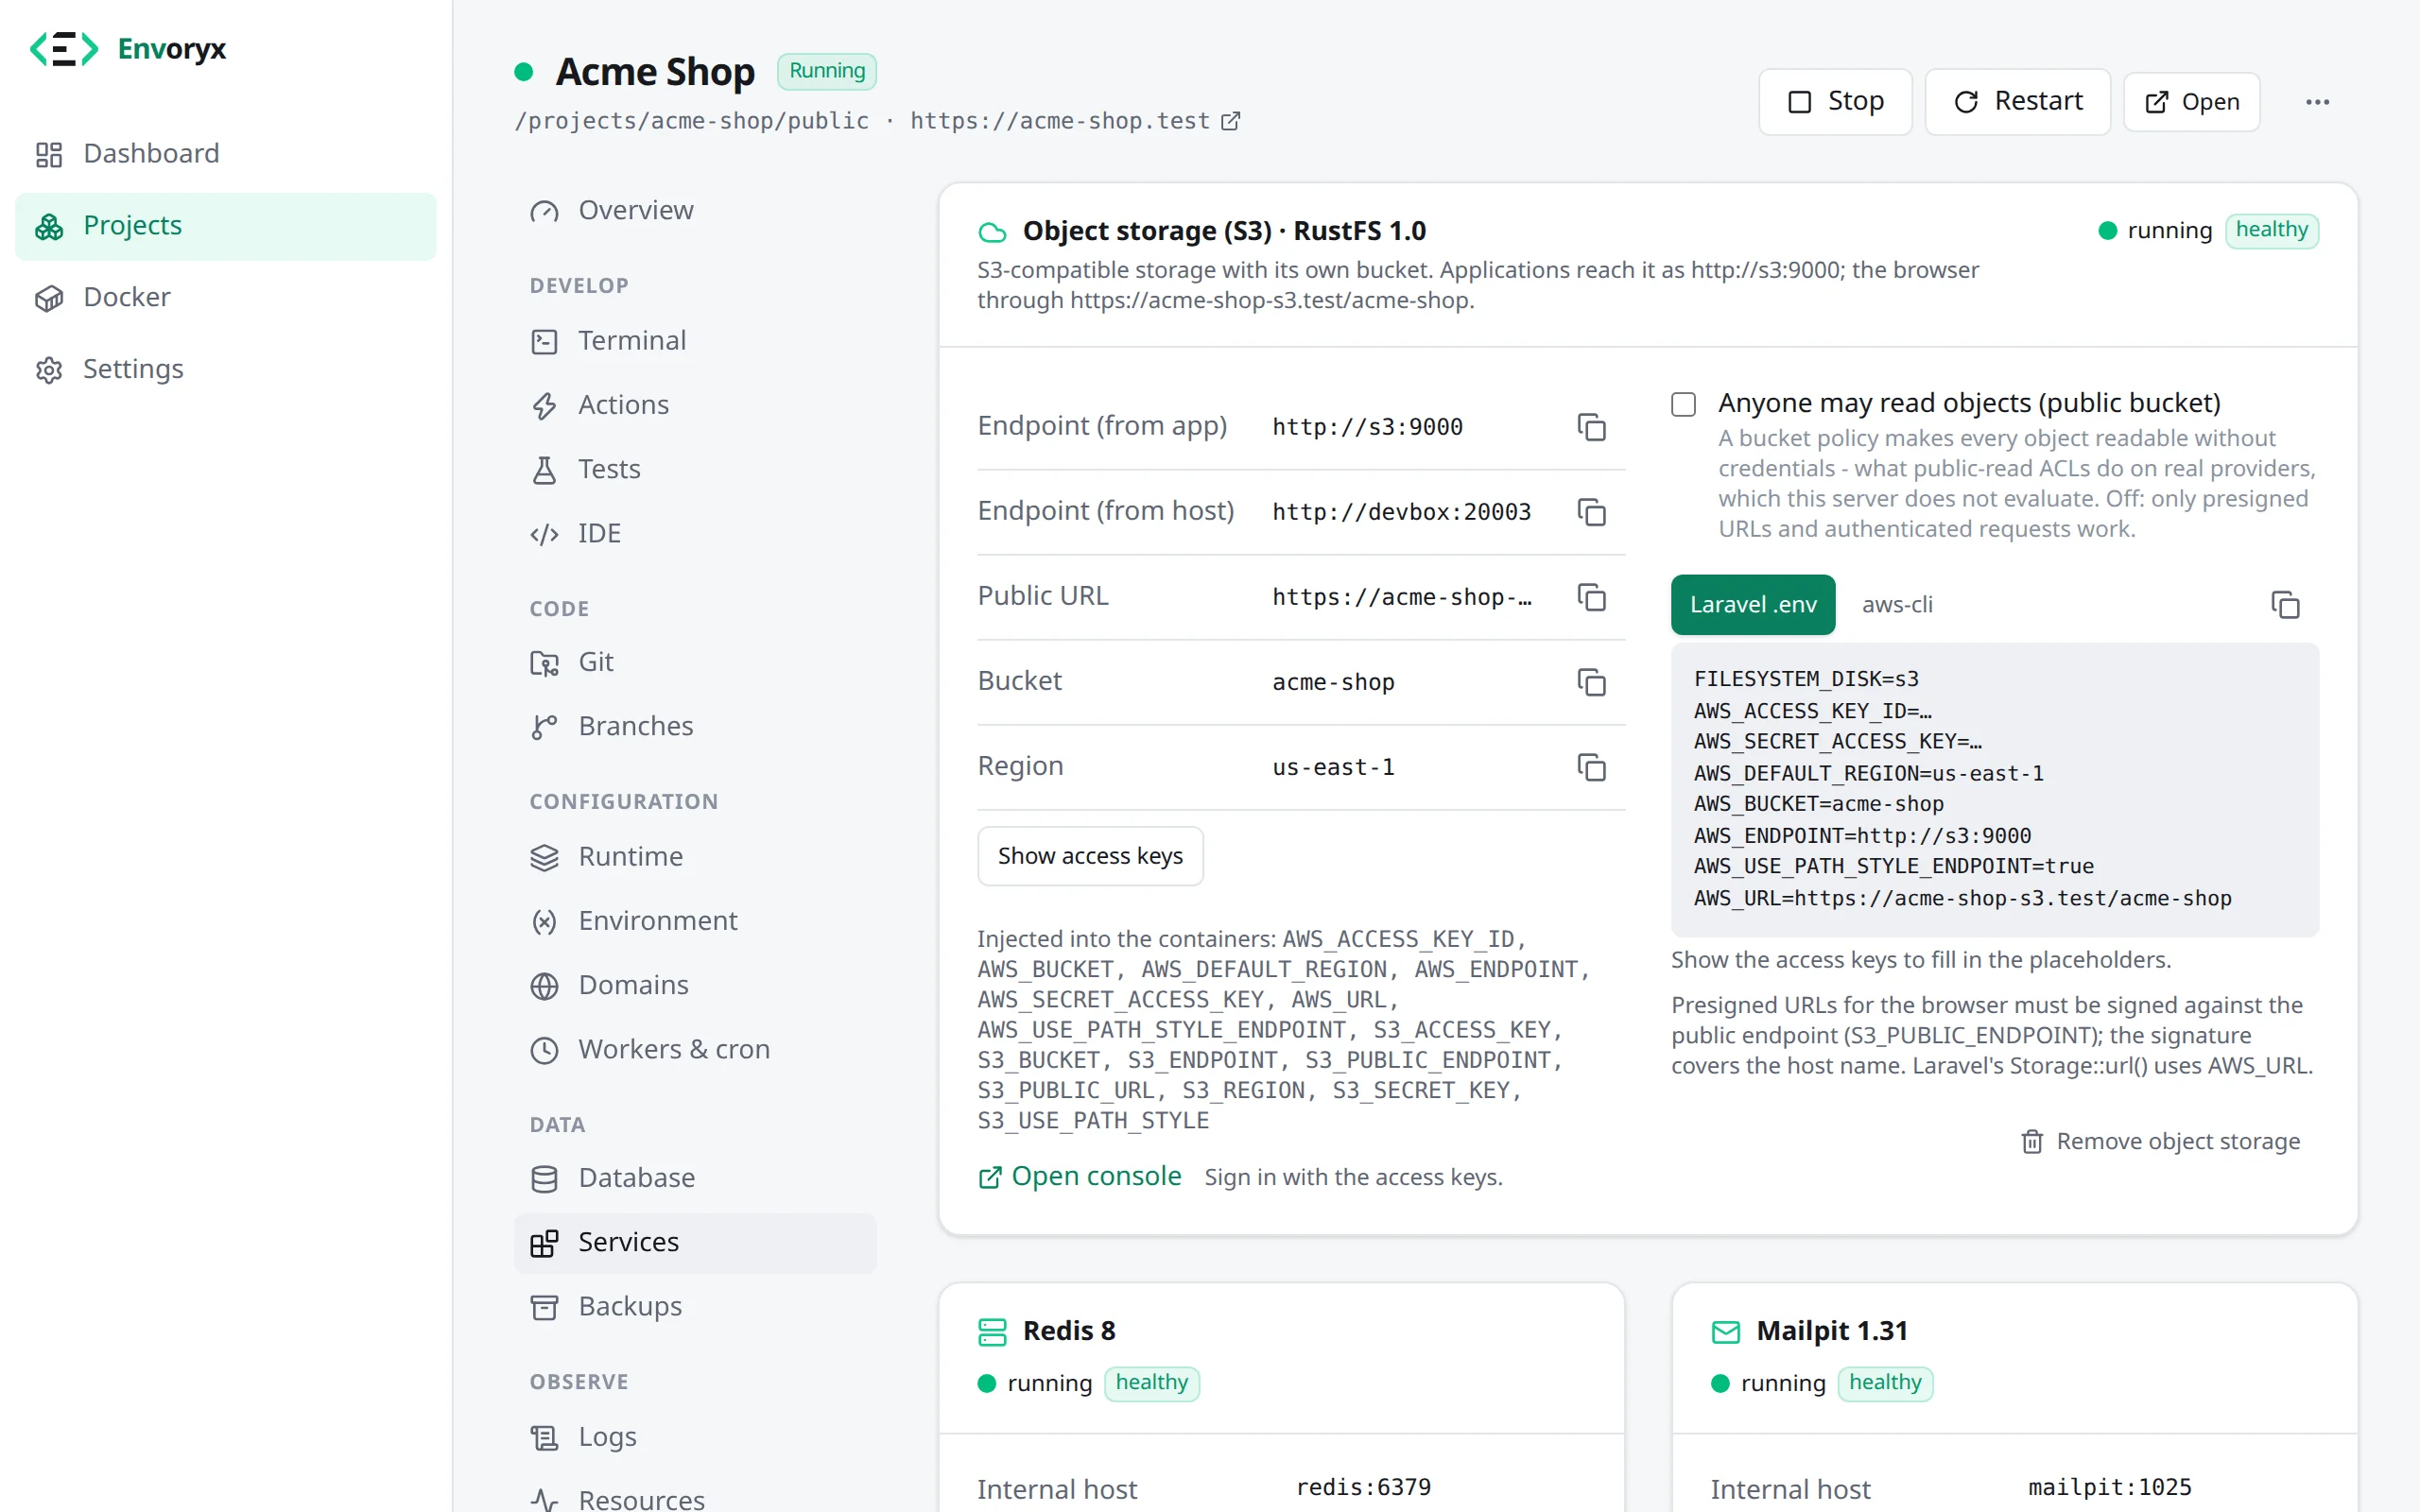
So heißen die Dienste im Projekt, und das bekommt deine Anwendung:
| Dienst | Host im Projekt | Variablen für die Anwendung |
|---|---|---|
| Redis | redis:6379 |
REDIS_HOST, REDIS_PORT, REDIS_URL (plus REDIS_PASSWORD bei einem externen Server) |
| Memcached | memcached:11211 |
MEMCACHED_HOST, MEMCACHED_PORT, MEMCACHED_URL |
| Mailpit | mailpit:1025 (SMTP) |
MAIL_MAILER, MAIL_HOST, MAIL_PORT, MAIL_ENCRYPTION, MAILER_DSN, SMTP_HOST, SMTP_PORT |
| RabbitMQ | rabbitmq:5672 |
RABBITMQ_HOST, RABBITMQ_PORT, RABBITMQ_USER, RABBITMQ_PASSWORD, RABBITMQ_VHOST, RABBITMQ_URL |
| Meilisearch | meilisearch:7700 |
MEILISEARCH_HOST, MEILISEARCH_URL, MEILISEARCH_KEY, MEILISEARCH_API_KEY |
| Typesense | typesense:8108 |
TYPESENSE_HOST, TYPESENSE_PORT, TYPESENSE_PROTOCOL, TYPESENSE_API_KEY, TYPESENSE_URL |
| OpenSearch | opensearch:9200 |
OPENSEARCH_HOST, OPENSEARCH_PORT, OPENSEARCH_SCHEME, OPENSEARCH_URL |
| Ollama | ollama:11434 |
OLLAMA_HOST, OLLAMA_BASE_URL, OLLAMA_URL |
| Objektspeicher | s3:9000 |
S3_* und AWS_* (siehe unten) |
Das sind genau die Namen, nach denen Laravel, Symfony und die üblichen Client-Bibliotheken suchen - die meisten Anwendungen laufen also ohne jede Konfiguration. Setzt du eine dieser Variablen selbst im Projekt, gilt dein Wert. In einem PHP-Projekt schaltet das Hinzufügen von Redis, Memcached oder RabbitMQ außerdem PHPs Erweiterung redis, memcached oder amqp ein, der Client ist also da, wenn dein Code ihn braucht.
Du brauchst etwas, das hier nicht dabei ist, etwa phpMyAdmin oder Elasticsearch? Dafür gibt es Addons.
Redis und Memcached
Abschnitt betitelt „Redis und Memcached“Redis legt seine Daten in einem dauerhaften Volume ab, ein Neustart leert es also nicht. Läuft bei dir schon irgendwo ein Redis, kann das Projekt auch den benutzen statt eines Containers: Wähle beim Hinzufügen Auf einem externen Server, trag Host, Port und gegebenenfalls das Passwort ein und klick auf Verbindung testen. Envoryx ändert an diesem Server nie etwas, und nimmst du Redis aus dem Projekt, vergisst es nur die Verbindung.
Memcached ist ein schlichter Cache im Arbeitsspeicher. Über einen Neustart rettet er nichts - dafür ist ein Cache ja auch da.
Mailpit
Abschnitt betitelt „Mailpit“Mailpit würde ich fast jedem Projekt spendieren. Es fängt jede E-Mail ab, die deine Anwendung per SMTP verschickt, und zeigt sie in einem Web-Postfach. So testest du Registrierungs- und Passwort-Mails, ohne dass irgendetwas dein Netz verlässt. Das Postfach öffnest du im Bereich Dienste. Weil es auf dem Port von Mailpit liegt, ist dieser Port immer veröffentlicht.
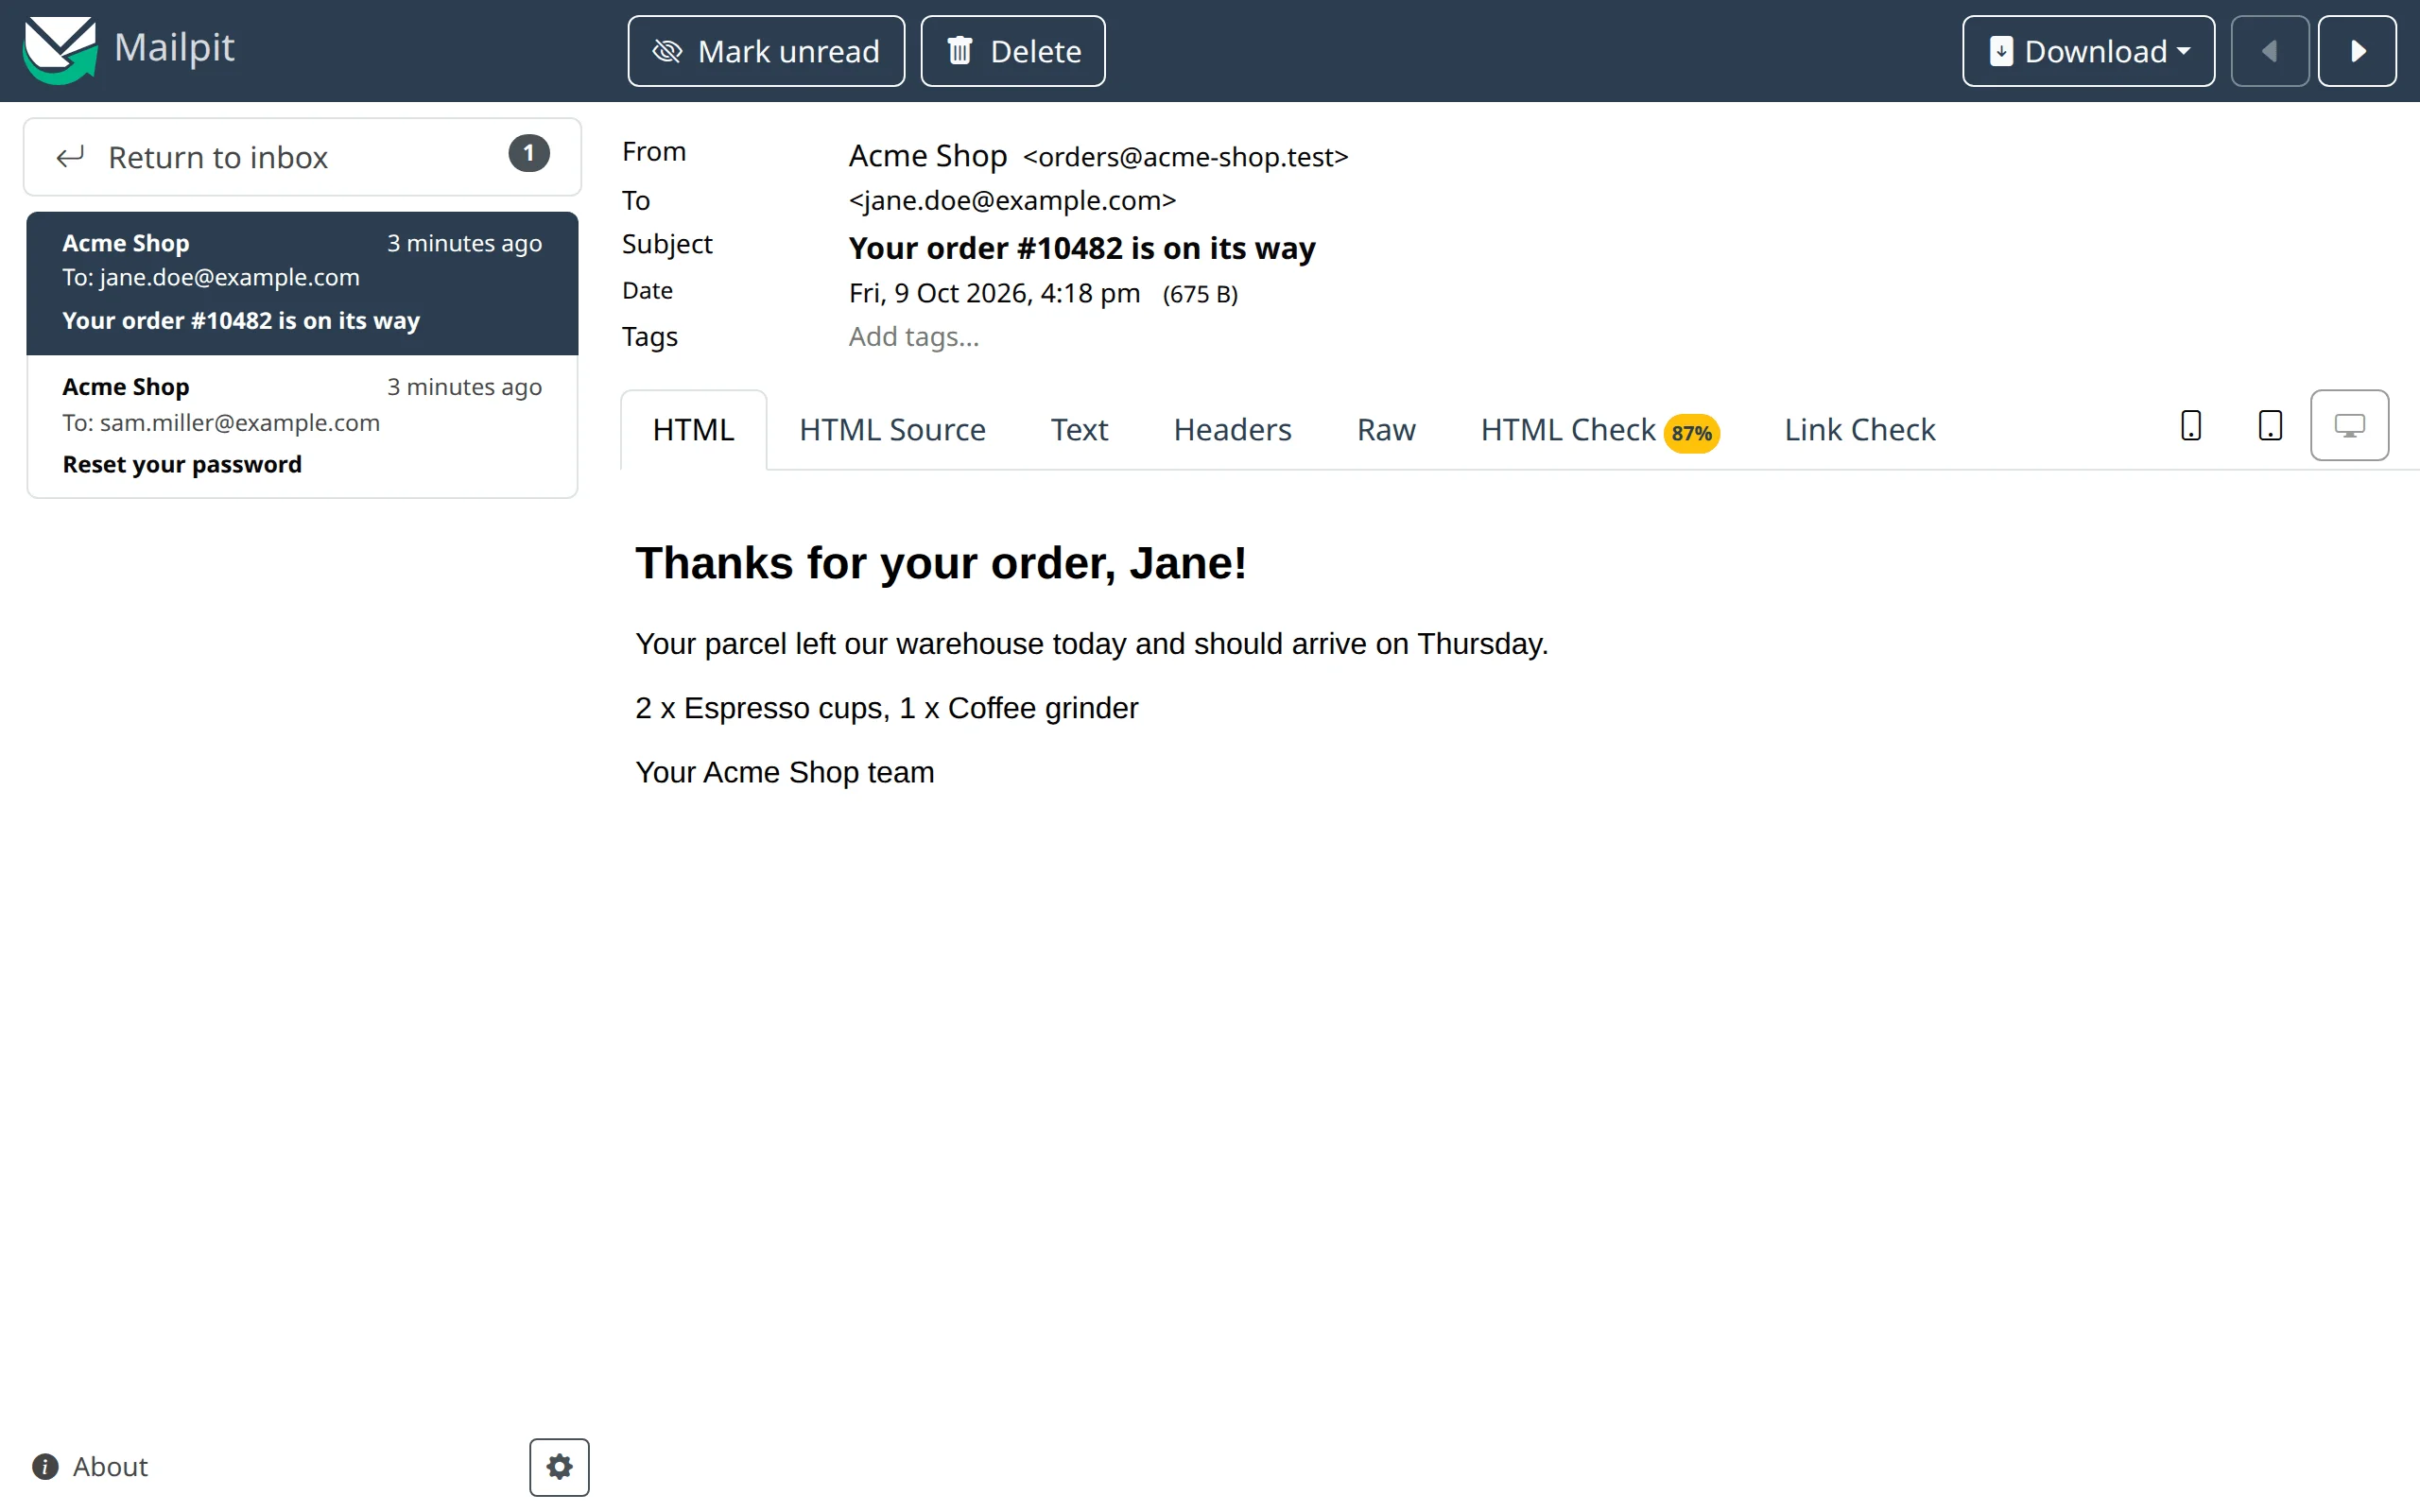
Auch das schlichte mail() von PHP kommt dort an. Die PHP-Images bringen msmtp mit, und solange Mailpit an ist, verschickt sendmail_path darüber. So landet auch alter Code im Postfach, der von SMTP nie etwas gehört hat. Ohne Mailpit gibt mail() false zurück.
Die meisten Frameworks finden Mailpit ohne dein Zutun. Laravel und Symfony lesen MAIL_* und
MAILER_DSN ohnehin aus der Umgebung, und die Templates für TYPO3, Rails und Django sind so
eingerichtet, dass sie über MAIL_HOST oder SMTP_HOST verschicken, solange das Projekt Mailpit hat.
Nimmst du Mailpit wieder raus, machen sie weiter wie vorher.
Mailpit hält die Mails nur in seinem Container, jeder Neustart des Projekts leert das Postfach also. Für Testmails ist das meist genau richtig, wundere dich nur nicht, wenn die Mails von gestern weg sind. Einen Worker oder Cron-Job hinzuzufügen lässt Mailpit und sein Postfach dagegen in Ruhe.
RabbitMQ
Abschnitt betitelt „RabbitMQ“Ein Message-Broker mit seiner Management-Oberfläche und einem erzeugten Login. RABBITMQ_URL ist eine fertige amqp://-URL für den Standard-vhost /.
Das RabbitMQ 4, das Envoryx betreibt, erlaubt keine Queues mehr, die weder durable noch exclusive sind. Wer so eine anlegt, bekommt 541 INTERNAL_ERROR - Feature transient_nonexcl_queues is deprecated. Ältere Tutorials und manche Client-Voreinstellungen legen genau solche Queues an. Deklarier die Queue als durable (oder exclusive, für eine kurzlebige Antwort-Queue), dann klappt es.
Suchmaschinen
Abschnitt betitelt „Suchmaschinen“Drei stehen zur Wahl. Meilisearch bringt ein Web-Dashboard und einen erzeugten Master-Key mit (sein Port ist immer veröffentlicht, weil dort das Dashboard liegt), Typesense einen erzeugten API-Key. OpenSearch ist die Elasticsearch-kompatible Variante: ein einzelner Knoten ohne Login. Envoryx gibt ihm 512 MB Java-Heap, damit braucht der ganze Container etwa 1 GB Arbeitsspeicher - auf einem kleinen Rechner solltest du das im Blick haben. Setzt du unter Ressourcenlimits ein Speicherlimit für die Dienste des Projekts, gilt es für jeden Dienst-Container einzeln, und OpenSearch braucht davon mindestens 1,5 GiB. Wer darin herumklicken möchte, nimmt OpenSearch Dashboards dazu, die Web-Oberfläche mit der Dev-Tools-Konsole.
Ollama (lokale LLMs)
Abschnitt betitelt „Ollama (lokale LLMs)“Ollama lässt Sprachmodelle auf deiner eigenen Hardware laufen. Die Modelle lädst du auf der Ollama-Karte: Gib einen Namen aus der Ollama-Bibliothek ein - llama3.2, qwen3:8b, nomic-embed-text, hf.co/<org>/<repo>:<quant> und so weiter - und schau zu, wie es ankommt. Der Download läuft weiter, wenn du die Seite verlässt, und lässt sich abbrechen. Das Projekt muss dafür laufen.
Modelle sind groß, jedes mehrere GB. Deshalb teilen sich alle Projekte einen Modellspeicher unter /config/ollama: Ein Modell wird einmal geladen und steht jedem Projekt zur Verfügung - löschst du es, ist es aber auch für alle weg. Nimmst du Ollama aus einem Projekt, bleibt der Speicher unberührt.
GPU. GPU nutzen reicht die NVIDIA-GPUs des Hosts an den Container durch. Dafür braucht Docker das NVIDIA Container Toolkit, unter Unraid ist das das Plugin Nvidia Driver mit anschließendem Neustart von Docker. Bevor Envoryx die GPU einschaltet, startet es einen kurzen Testcontainer; klappt das Durchreichen nicht, sagt es dir das, und Ollama rechnet weiter auf der CPU. Auch ganz ohne GPU antworten kleine Modelle bis etwa 4B Parameter auf einer aktuellen CPU ordentlich schnell.
envoryx project create "Assistant" --python 3.13 --ollama-gpuObjektspeicher (S3)
Abschnitt betitelt „Objektspeicher (S3)“Legt deine Anwendung Uploads in S3 ab, kannst du auch das lokal testen. Objektspeicher betreibt für das Projekt einen S3-kompatiblen Server (RustFS), erzeugt ein Schlüsselpaar und legt einen Bucket mit dem Namen des Projekts an. Deine Anwendung bekommt zwei Sätze Variablen, einen allgemeinen und einen mit den Namen, die Laravel und das AWS SDK erwarten:
| Allgemein | Laravel / AWS SDK | Wert |
|---|---|---|
S3_ENDPOINT |
AWS_ENDPOINT |
http://s3:9000 (im Projekt) |
S3_REGION |
AWS_DEFAULT_REGION |
us-east-1 |
S3_BUCKET |
AWS_BUCKET |
der Slug des Projekts |
S3_ACCESS_KEY |
AWS_ACCESS_KEY_ID |
erzeugt |
S3_SECRET_KEY |
AWS_SECRET_ACCESS_KEY |
erzeugt |
S3_USE_PATH_STYLE |
AWS_USE_PATH_STYLE_ENDPOINT |
true |
S3_PUBLIC_URL |
AWS_URL |
https://<projekt>-s3.<basis>/<bucket> |
S3_PUBLIC_ENDPOINT |
- | https://<projekt>-s3.<basis> |
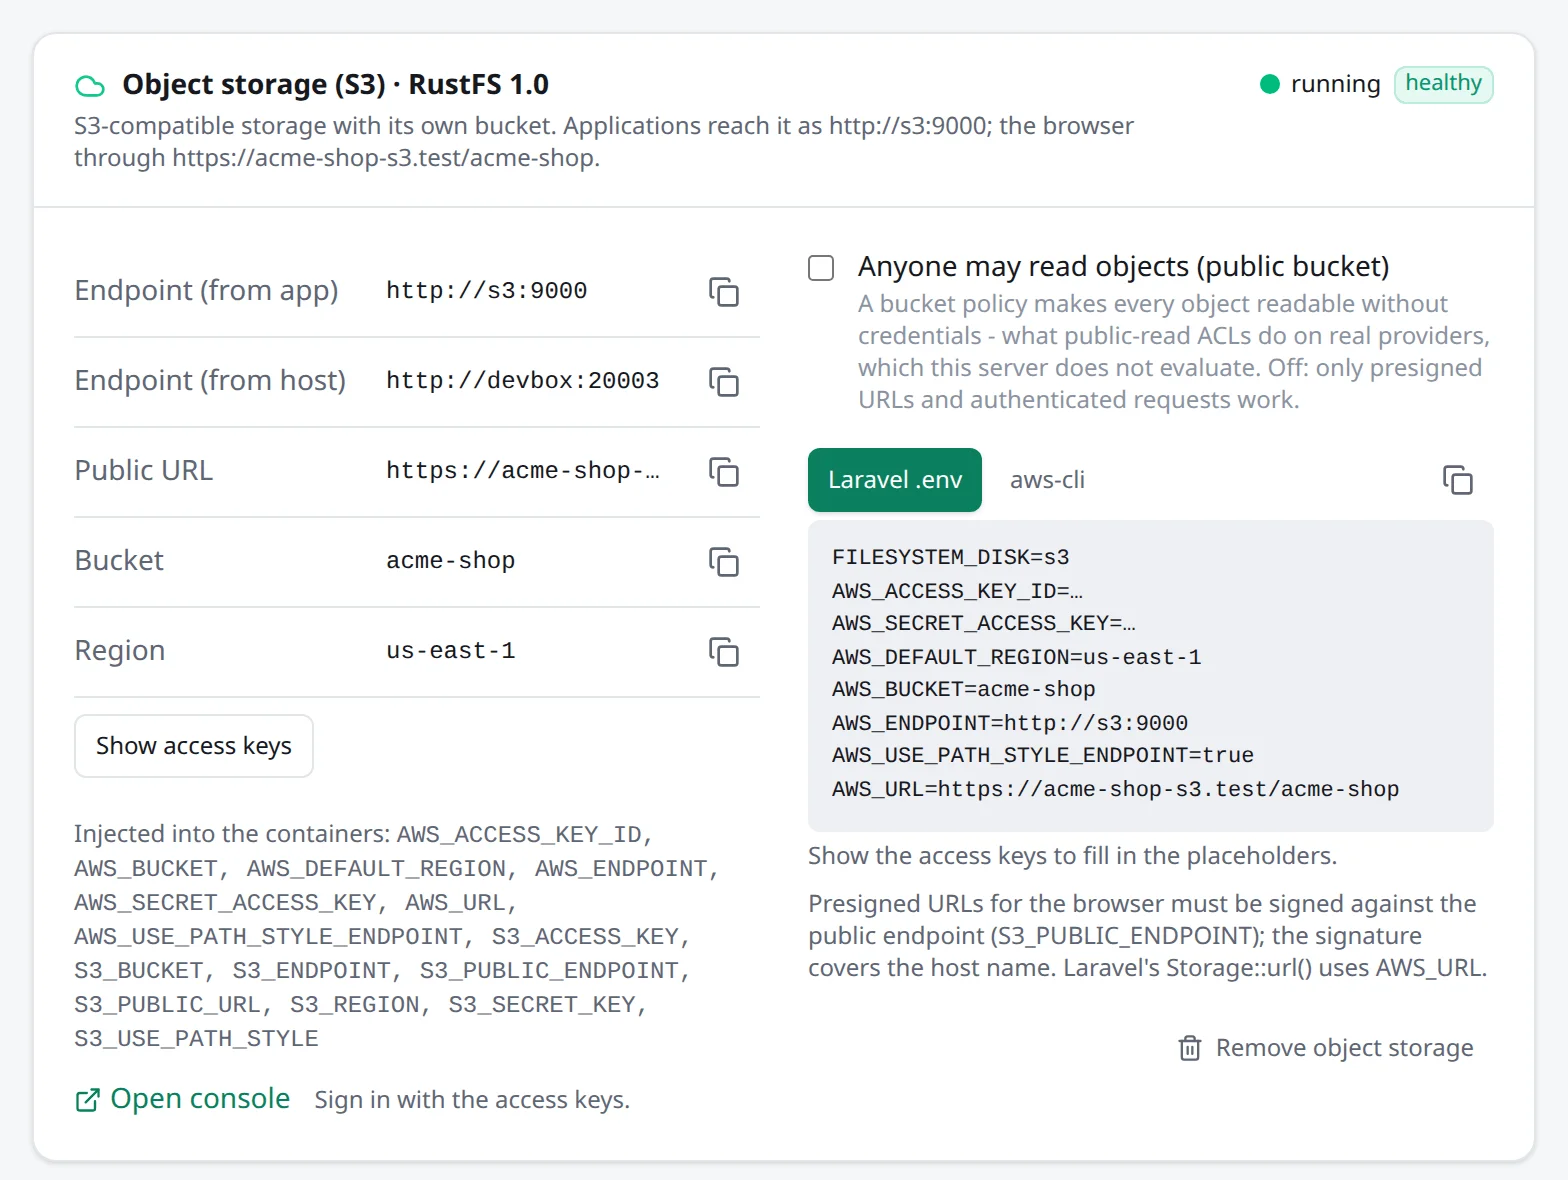
Eine Laravel-s3-Disk funktioniert mit FILESYSTEM_DISK=s3, sobald der S3-Treiber installiert ist. Ein frisches Laravel hat ihn nicht, also führ zuerst composer require league/flysystem-aws-s3-v3 aus; ohne ihn bricht Laravel mit einem Class-not-found-Fehler ab, sobald es die Disk anfasst.
Auch dein Browser kommt an den Bucket heran: Der Proxy stellt die S3-API unter <projekt>-s3.<basis-domain> bereit, damit funktionieren Storage::url()-Links, öffentliche Dateien und direkte Uploads. Ein Stolperstein sind Presigned URLs: Soll ein Browser sie benutzen, signier sie gegen S3_PUBLIC_ENDPOINT. Eine für s3:9000 signierte URL funktioniert nur innerhalb des Projektnetzes.
In Laravel heißt das: eine zweite Disk neben s3, die sich nur im Endpunkt unterscheidet. Signiert
wird lokal ohne Request, es macht also nichts, dass die App selbst diese Adresse nicht erreicht:
// config/filesystems.php, unter 'disks''s3public' => [ 'driver' => 's3', 'key' => env('AWS_ACCESS_KEY_ID'), 'secret' => env('AWS_SECRET_ACCESS_KEY'), 'region' => env('AWS_DEFAULT_REGION'), 'bucket' => env('AWS_BUCKET'), 'endpoint' => env('S3_PUBLIC_ENDPOINT'), 'use_path_style_endpoint' => true,],Hochladen tust du wie gewohnt über die Disk s3, den Link erzeugst du mit
Storage::disk('s3public')->temporaryUrl($path, now()->addMinutes(10)). Die Option temporary_url
der Disk hilft hier nicht weiter, weil der Hostname Teil der Signatur ist.
Ein neuer Bucket ist privat: An die Objekte kommen nur Presigned URLs und authentifizierte Anfragen. Verlinkt deine Anwendung Dateien mit Storage::url() und erwartet, dass sie sich wie bei einem öffentlichen Bucket in Produktion öffnen, schalte Jeder darf Objekte lesen (öffentlicher Bucket) ein, gleich beim Hinzufügen oder später im Bereich Dienste. RustFS ignoriert public-read-ACLs, deshalb erledigt Envoryx das mit einer Bucket-Policy, die jedem das Lesen aller Objekte erlaubt. Denk daran, was das heißt: Wer den S3-Hostnamen des Projekts erreicht, kann die Objekte dann lesen. In der envoryx.yml steht dafür storage: {publicRead: true}, in der API "publicRead": true.
Buckets aus Envoryx 0.17 und älter waren standardmäßig öffentlich und behalten diese Einstellung. Eine envoryx.yml ohne publicRead lässt einen bestehenden Bucket in Ruhe, ein Update sperrt deine Dateien also nicht still und leise weg.
RustFS hat eine eigene Konsole, die du im Bereich Dienste öffnest; angemeldet wirst du mit den Schlüsseln des Projekts. S3-API und Konsole liegen außerdem auf Host-Ports, damit lokale Werkzeuge wie aws s3 --endpoint-url sie erreichen.
Backups können den Bucket mitnehmen. Jedes Objekt landet als normale Datei in storage.tar.gz, die du mit jedem tar öffnen kannst. Entfernst du den Objektspeicher, wird das Volume des Buckets gelöscht - deshalb will Envoryx vorher den Bucket-Namen von dir hören.
Einen Dienst entfernen
Abschnitt betitelt „Einen Dienst entfernen“Nimmst du Redis, RabbitMQ, Meilisearch, Typesense oder OpenSearch aus dem Projekt, verschwindet der Container, die Daten aber bleiben, solange du im Dialog nicht Daten löschen wählst (und zur Bestätigung den Namen des Dienstes eintippst). Das ist Absicht: Wer eine Suchmaschine eine Weile herausnimmt, soll dafür nicht den Index verlieren. Fügst du den Dienst später wieder hinzu, übernimmt er die Daten samt den Zugangsdaten, mit denen er angelegt wurde. Das Passwort von RabbitMQ und die Keys der Suchmaschinen sind also dieselben wie vorher.
Bis dahin nennt die Karte, mit der du den Dienst hinzufügst, das behaltene Volume und bietet Behaltene Daten löschen an. Behaltene Daten gehören nicht zu den Projekt-Backups, verlass dich also nicht darauf wie auf ein Backup. Beim Umbenennen des Projekts ziehen sie mit um, und mit dem Projekt werden sie gelöscht.
Memcached, Mailpit und Ollama haben keine eigenen Daten, und ein externes Redis hatte Envoryx ohnehin nie zu löschen. Objektspeicher und Datenbanken löschen ihre Daten beim Entfernen weiterhin, deshalb fragen sie nach dem Namen.