
Ruby
Starte im Assistenten mit einer Ruby-Vorlage oder wähl Ruby-Anwendung für ein leeres Projekt
oder ein Repository, oder nimm Ruby im Bereich Laufzeit zu einem
bestehenden Projekt dazu. Der Container envoryx-<projekt>-ruby läuft mit
ghcr.io/envoryx/envoryx-ruby:<version>. Das ist das offizielle Image ruby:<version>-slim-bookworm,
dazu alles, was die gängigen nativen Gems zum Kompilieren brauchen (pg, mysql2, sqlite3, psych),
libvips für die Bildvarianten des Standard-Prozessors :vips von Active Storage und das debug-Gem. Er läuft als PUID:PGID, mit deinem Projekt unter /var/www/html und einem
Home-Verzeichnis unter /home/envoryx.
Gems werden nach GEM_HOME=/home/envoryx/.gem/ruby/<X.Y.0> installiert, bei Ruby 3.4 also nach
~/.gem/ruby/3.4.0. Das ist das Verzeichnis, das RubyGems selbst für User-Installationen nimmt. Deshalb
findet Ruby Gems, die eine IDE dort installiert (etwa die Debugger-Gems von RubyMine), ohne Tricks mit
GEM_PATH, und Gems, die für eine Ruby-Version gebaut sind, begegnen nie einer anderen. Sie überstehen
es, wenn der Container neu erstellt wird, und in deinem Projektordner liegt kein vendor/bundle. Der
Download-Cache von Bundler liegt im Paket-Cache des Projekts, ein
neues Installieren des Bundles lädt die Gems also nicht noch einmal. Schaltest du dort das Teilen ein,
nutzen alle Projekte einen Cache, und die zweite Rails-App installiert sich deutlich schneller als die
erste.
Projekte von vor Envoryx 0.17.0 haben ~/.gem/ruby ohne Version benutzt. Sie installieren ihr Bundle
beim ersten Neustart nach dem Update noch einmal, und den alten Inhalt von ~/.gem/ruby im
Projekt-Home kannst du löschen.
Node.js steckt nicht im Image. Nutzt du jsbundling-rails oder cssbundling-rails, nimm für diese
Builds einen Node.js-Dienst neben Ruby dazu. Das Rails-Template arbeitet mit importmap und braucht Node
überhaupt nicht.
Versionen
Abschnitt betitelt „Versionen“Standard ist 4.0, außerdem gibt es 3.4 und 3.3.
Der Server
Abschnitt betitelt „Der Server“Schalte Ruby-Server ausführen ein und wähl eine Vorlage. Der Server wird zum Hauptprozess des Containers, startet automatisch neu und bekommt einen eigenen Host-Port. Schaltest du den Server aus und wieder ein, behält er diesen Port, ein Lesezeichen darauf bleibt also gültig.
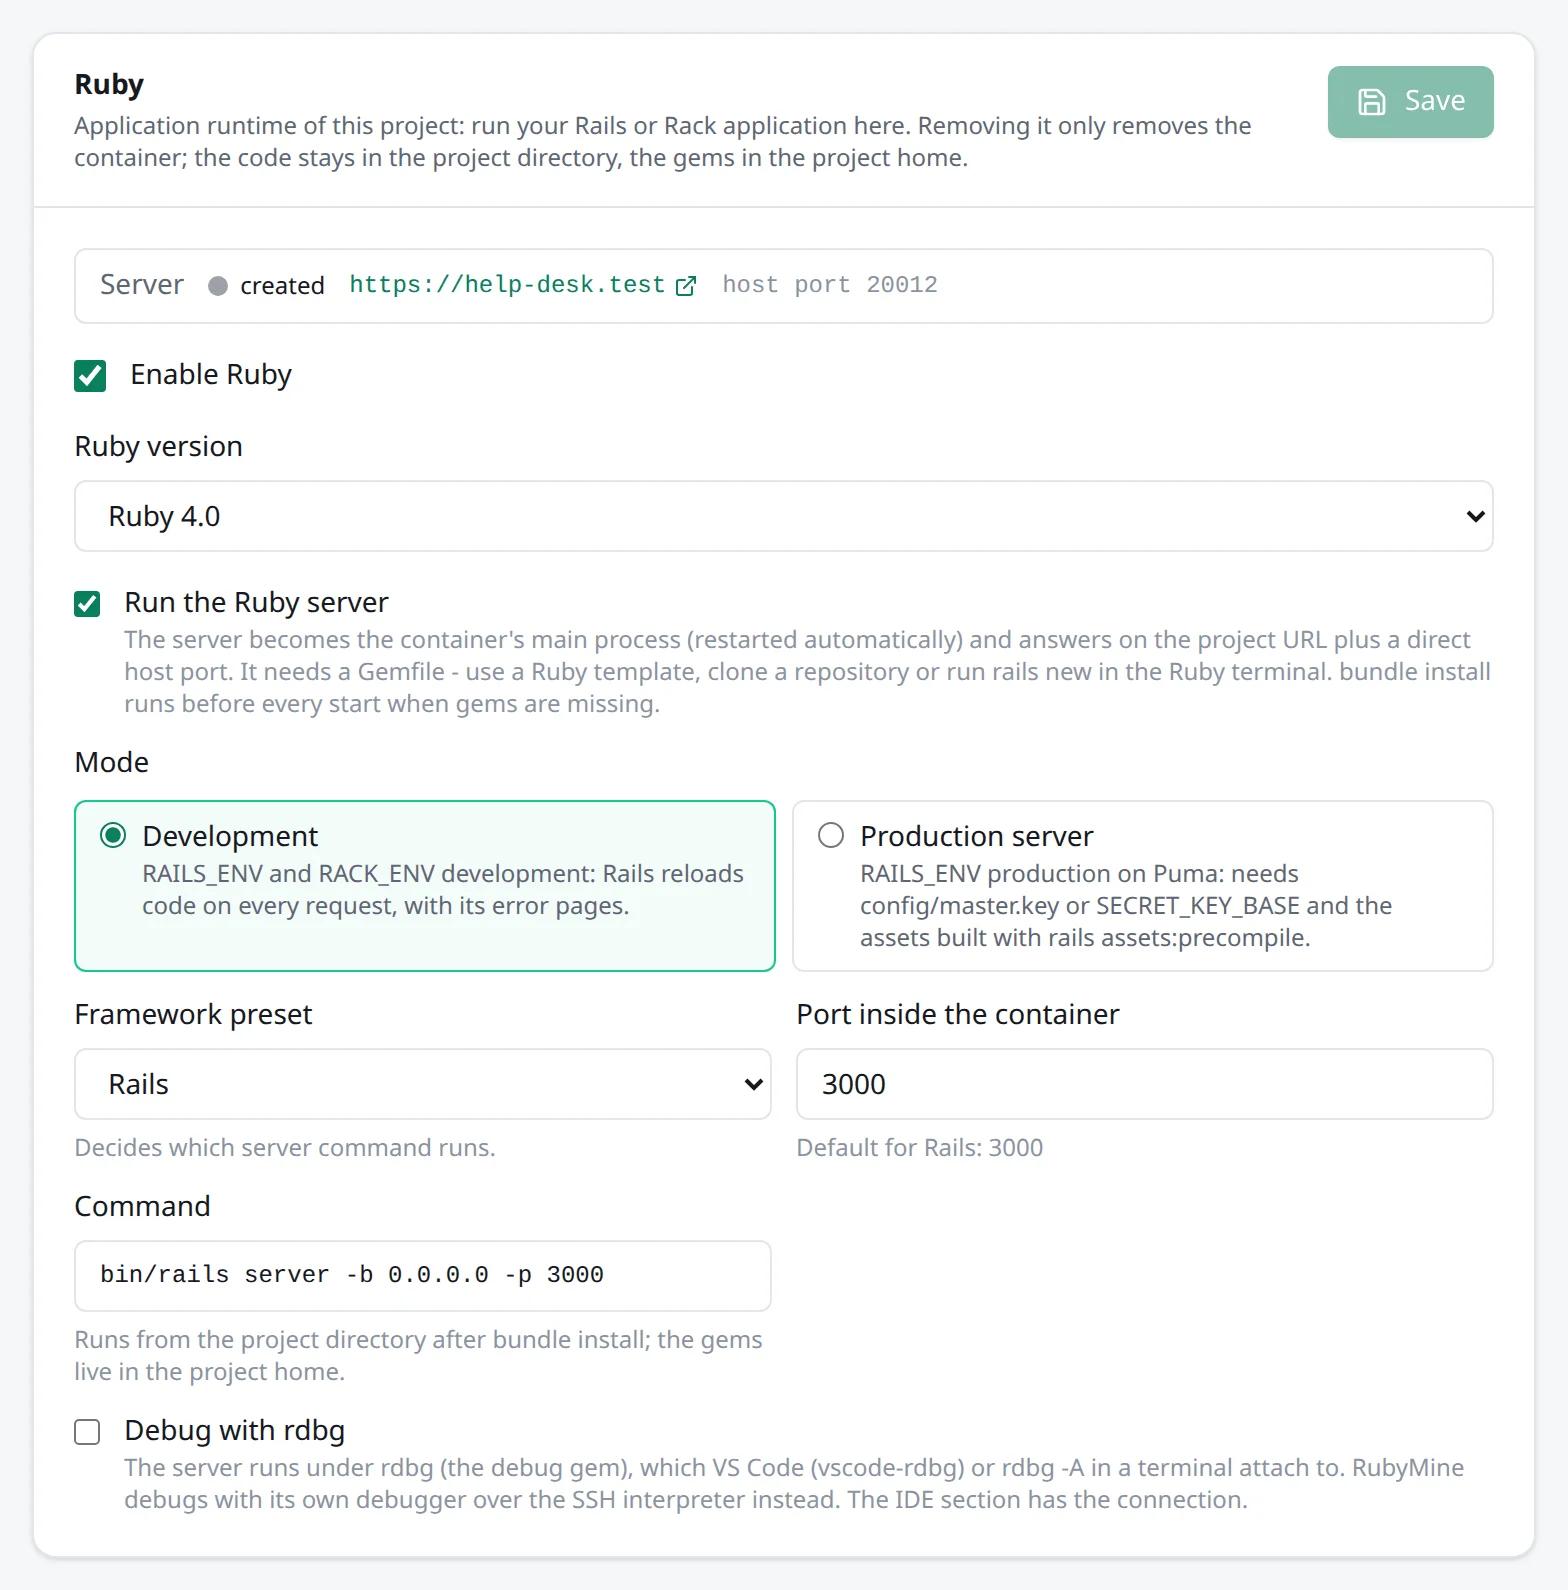
| Vorlage | Entwicklung | Produktion | Port |
|---|---|---|---|
| Rails | bin/rails server - Rails lädt geänderten Code selbst neu |
bundle exec puma |
3000 |
| Rack | Puma mit config.ru (Sinatra, Roda, Hanami …) |
genauso | 9292 |
Der Server lauscht auf $PORT, HOST und BINDING stehen auf 0.0.0.0. RAILS_ENV, RACK_ENV,
APP_ENV und HANAMI_ENV folgen dem Modus, und deine Worker bekommen dieselben Werte. Mit der
Rack-Vorlage ist das Neuladen von geändertem Code Sache des Frameworks - bei Sinatra etwa
sinatra/reloader.
Rails lehnt Anfragen für Hostnamen ab, die es nicht kennt. In der Entwicklung setzt Envoryx
RAILS_DEVELOPMENT_HOSTS=.<basis>, damit die Namen deines Projekts durchkommen, ohne dass du
config.hosts anfassen musst.
Der Produktionsmodus ist wirklich die Production-Umgebung von Rails, mit allem, was dazugehört. Er
braucht config/master.key (oder SECRET_KEY_BASE als Projektvariable), vorkompilierte Assets - dafür
rails assets:precompile ausführen - und die Datenbanken, die deine database.yml für Production
nennt. Rails liefert public/ dann selbst aus, und steht in deiner Production-Konfiguration
force_ssl, leitet es auf https um.
Das Bundle kümmert sich um sich selbst
Abschnitt betitelt „Das Bundle kümmert sich um sich selbst“Bevor der Server startet, wartet er auf das Gemfile (und bin/rails oder config.ru). Dann führt er
bundle check aus und, falls etwas fehlt - nach einem frischen Klon, einem geänderten Gemfile oder
einem Ruby-Upgrade -, bundle install. Eine geklonte Anwendung kommt also einfach hoch, ohne dass du
von Hand etwas ausführst. Schlägt die Installation fehl, steht das im Log, und es gibt alle 30 Sekunden
einen neuen Versuch. Worker machen dasselbe, bevor sie starten.
Diese Prüfung passiert allerdings beim Start. Ein Server, der schon läuft, behält das Bundle, mit dem er
gestartet ist. Nach einem bundle add oder einer Änderung am Gemfile startest du das Projekt also neu,
dann kommen Server und Worker mit den neuen Gems hoch; bis dahin gibt es für das neue Gem einen
LoadError.
Datenbank
Abschnitt betitelt „Datenbank“Envoryx speist DATABASE_URL ein, und Rails übernimmt das von selbst in config/database.yml. Bei
PostgreSQL bekommen die Ruby-Container den Wert als postgresql://…, in der Form, die Active Record
versteht. Eine zusätzliche Datenbank namens analytics taucht als ANALYTICS_DATABASE_URL auf, und das
Multi-Database-Setup von Rails greift sie für eine Datenbank analytics in der database.yml auf.
Solid Queue bekommt eine eigene Datenbank, so wie Rails das für die Produktion einrichtet. Die
Ruby-Container erhalten QUEUE_DATABASE_URL, das auf <database>_queue auf dem Datenbankserver des
Projekts zeigt, und Rails übernimmt es in den Eintrag queue der database.yml. Rails 8 schreibt
diesen Eintrag für die Produktion, die Rails-Templates legen auch einen für die Entwicklung an, und
einen cable-Eintrag daneben. Sobald
die database.yml einen queue-Eintrag hat, legt Envoryx die Queue-Datenbank an (als Administrator,
wie die Testdatenbank), und rails db:prepare spielt die Tabellen von Solid Queue dort ein.
Solid Cache und Solid Cable funktionieren genauso. CACHE_DATABASE_URL zeigt auf <database>_cache
und CABLE_DATABASE_URL auf <database>_cable, passend zu den Einträgen cache und cable, die
Rails 8 für die Produktion schreibt, und Envoryx legt diese Datenbanken an, wenn die database.yml
die Einträge hat. Ruby-Projekte von vor 0.18 melden wegen der zwei neuen Variablen einmal einen
älteren Stand; starte sie neu, wenn es dir passt.
Das Rails-Template lässt den Cache in der Entwicklung auf :memory_store. Willst du auch dort Solid
Cache, ergänzt du im Abschnitt development der database.yml einen cache-Eintrag (wie den für die
Produktion, mit migrations_paths: db/cache_migrate), lässt config/cache.yml mit database: cache
darauf zeigen, setzt config.cache_store = :solid_cache_store in der development.rb und führst rails
db:prepare aus.
Diese Datenbanken gehören zum Projekt wie die Hauptdatenbank. Backups und Wiederherstellungen
enthalten die Datenbanken _queue, _cache und _cable, ein Duplikat und eine Wiederherstellung in
ein neues Projekt bringen sie mit, und beim Umbenennen ziehen sie zum neuen Namen um. Wartende Jobs von
Solid Queue überstehen also eine Wiederherstellung, und eine Kopie scheitert nicht an einer fehlenden
Queue-Datenbank.
Wo er antwortet
Abschnitt betitelt „Wo er antwortet“Ohne PHP und ohne Python- oder Go-Server ist der Ruby-Server die Anwendung: https://<projekt>.<basis>
und jede zusätzliche Domain landen direkt bei ihm, der Port des Webserver-Containers bleibt zu, und
Direktzugriff ist der Ruby-Host-Port. Neben PHP, einem Python- oder einem Go-Server hat er nur seinen
eigenen Host-Port. Ein Node.js-Dev-Server neben Ruby behält <projekt>-dev.<basis>.
Templates
Abschnitt betitelt „Templates“Rails führt rails new mit Hotwire und importmap aus, Rails (API only) führt rails new --api
aus. Beide werden nach deinem Projekt benannt und für seine Datenbank eingerichtet - PostgreSQL, MySQL
oder MariaDB, und SQLite, wenn das Projekt keine hat. Beim ersten Mal dauert das ein paar Minuten, weil
die nativen Gems kompiliert werden. Scheitert unterwegs bundle install, etwa ohne Netz oder an einem
Gem, das sich nicht bauen lässt, schlägt das Template mit dem Grund fehl, statt eine halbe Anwendung zu
hinterlassen. Sobald das Projekt läuft, führt Envoryx rails db:prepare für dich aus; hast du es
gestoppt angelegt, startest du das im Bereich Aktionen, bevor du die Seite öffnest.
Außerdem richten die Templates die Entwicklungsumgebung für die Arbeit unter Envoryx ein:
- Solid Queue bekommt eine eigene Queue-Datenbank und Solid Cable eine eigene Cable-Datenbank (siehe
Datenbank), und Action Cable nutzt in der Entwicklung Solid Cable statt des
async-Adapters. Mitasyncverlässt ein Turbo-Broadcast aus einem Job nie den Worker-Prozess und kommt also nie im Browser an. Für Hintergrundjobs fügst du danach den Worker Solid Queue hinzu. lib/tasks/envoryx.rakesorgt dafür, dass rails db:prepare die Schemas für Queue und Cable in eine Datenbank lädt, die nur die Verwaltungstabellen von Rails hat. Wer die Seite vor dem erstendb:prepareöffnet, legt genau diese Tabellen an, unddb:preparehielte die Queue-Datenbank sonst für fertig.- Hat das Projekt Mailpit, liefert Action Mailer dorthin. Ohne diese Einstellung versucht Rails es auf
localhost:25und verwirft jede Mail stillschweigend. Links in Mails (post_urlin einer Mailer-View) zeigen auf die Projektadresse ausENVORYX_URL, nicht auf Rails’ Standardlocalhost:3000. - Server und Worker loggen zusätzlich nach stdout, damit der Bereich Logs sie zeigt;
log/development.logbleibt. - web-console akzeptiert die Netze des Containers. Auf einer Fehlerseite, die du über die Projekt-URL
erreichst, öffnet sich ihre Konsole trotzdem nicht: web-console prüft die Adresse des Browsers aus
X-Forwarded-For, und das ist dein Rechner, nicht der Proxy. Envoryx lässt das mit Absicht so, denn die Konsole führt beliebigen Ruby-Code aus, und sie für dein ganzes privates Netz zu öffnen, gäbe das jedem dort in die Hand. Nimm stattdessenrails consoleim Ruby-Terminal, oder trag, wenn du das Risiko eingehst, deine eigene Adresse inconfig.web_console.allowed_ipsin derdevelopment.rbein.
Sinatra schreibt eine app.rb, eine config.ru und ein Gemfile mit Puma, sinatra-contrib für
den Reloader und dem debug-Gem.
Active Storage auf dem Objektspeicher
Abschnitt betitelt „Active Storage auf dem Objektspeicher“Hat das Projekt einen Objektspeicher, kann Active Storage ihn als
S3-Dienst nutzen. Nimm aws-sdk-s3 ins Gemfile auf und trag einen Dienst in config/storage.yml ein:
envoryx: service: S3 endpoint: <%= ENV["S3_ENDPOINT"] %> access_key_id: <%= ENV["S3_ACCESS_KEY"] %> secret_access_key: <%= ENV["S3_SECRET_KEY"] %> region: <%= ENV["S3_REGION"] %> bucket: <%= ENV["S3_BUCKET"] %> force_path_style: trueDann setzt du config.active_storage.service = :envoryx. Von sich aus schickt Rails den Browser zu
einer URL, die für S3_ENDPOINT signiert ist, also http://s3:9000, und die gibt es nur im
Projektnetz. Am einfachsten kommst du mit config.active_storage.resolve_model_to_route = :rails_storage_proxy heraus: Dann liefert Rails die Dateien selbst unter der Projekt-URL aus.
Tests, die deine Daten nicht anfassen
Abschnitt betitelt „Tests, die deine Daten nicht anfassen“Der Bereich Tests führt bundle exec rspec aus, wenn es einen Ordner spec/ und rspec in der
Gemfile.lock gibt, und bin/rails test. Eine Rails-App mit rspec-rails bekommt beide Suites angeboten,
du nimmst die, die du benutzt. Beides läuft in der Test-Umgebung gegen <datenbank>_test
auf dem Datenbankserver deines Projekts.
Der letzte Punkt ist wichtiger, als er klingt. Active Record übernimmt DATABASE_URL in jede Umgebung,
die gerade läuft. Ein Testlauf würde seine Fixtures sonst in deine Entwicklungsdatenbank laden und deren
Tabellen leeren. Envoryx lenkt den Lauf deshalb auf die Testdatenbank um und legt sie vorher an. Das
macht es als Administrator, weil der Projekt-Login bei MySQL und MariaDB keine Datenbanken anlegen darf.
Das Schema lädt dann Rails. Ist rspec_junit_formatter in deinem Bundle, erscheinen Fehler pro Test.
rails test schreibt keinen Report, deshalb liest Envoryx seine Zusammenfassung und die Fehler, die
Rails ausgibt (Test, Meldung, Datei und Zeile), aus der Ausgabe - Zahlen und fehlgeschlagene Tests
bekommst du also auch hier.
Debugging
Abschnitt betitelt „Debugging“Mit rdbg debuggen startet den Server unter rdbg --open --nonstop aus dem debug-Gem, auf Port 12345,
solange du nichts anderes einstellst, und legt diesen Port auf einen Host-Port. Sperrt die
Gemfile.lock das debug-Gem - Rails und das Sinatra-Template tun das -, wird das rdbg aus deinem Bundle
genommen. So ist nur eine Version des Gems im Spiel.
In VS Code installierst du die Erweiterung VSCode rdbg Ruby Debugger und trägst das hier ein, mit Host und Port aus dem Bereich IDE:
{ "type": "rdbg", "name": "Attach to Envoryx", "request": "attach", "debugPort": "<host>:<port>", "localfsMap": "/var/www/html:${workspaceFolder}"}Im Terminal erledigt rdbg -A <host> <port> dasselbe.
rdbg nimmt immer nur einen Client an. Kommt ein Attach nicht zurück, hängt vermutlich noch eine frühere
Sitzung dran, etwa ein rdbg -A im Ruby-Terminal, das du geschlossen hast, ohne es zu beenden. Beende
diesen Prozess (pkill -f 'rdbg -A' im Ruby-Terminal) und verbinde dich neu.
Bei RubyMine ist es anders. Dessen Konfiguration Ruby remote debug spricht nur ruby-debug-ide, nicht
das debug-Gem, und kann sich deshalb nicht an rdbg hängen. Richte den Ruby-Container stattdessen als
SSH-Remote-Interpreter ein (Benutzer <projekt>.ruby, siehe IDE-Integration),
dann debuggt RubyMine mit seinem eigenen Debugger. Den rdbg-Schalter brauchst du dafür nicht, wohl
aber JetBrains Gateway für dieses Projekt erlauben im Bereich IDE, denn der Debugger von RubyMine
leitet einen Port über SSH weiter.
Ohne Server wird nur der Port veröffentlicht - für ein rdbg, das du selbst im Ruby-Terminal startest,
etwa rdbg --open --host=0.0.0.0 --port=12345 -c -- bin/rails test.
Aktionen und Worker
Abschnitt betitelt „Aktionen und Worker“Im Bereich Aktionen gibt es ruby --version, bundle install, bundle update, bundle outdated,
rubocop (wenn eine .rubocop.yml da ist) und für Rails db:prepare, db:migrate, db:rollback,
db:seed, routes, assets:precompile, tmp:clear und about.
Für Hintergrundjobs gibt es Worker für Solid Queue (bin/jobs start), GoodJob (good_job start,
auf Wunsch auf bestimmte Queues beschränkt), Sidekiq (auf Wunsch mit Queues - nimm Redis zum Projekt
dazu, dann wird REDIS_URL eingespeist), einen Rake-Task und ein Ruby-Skript. Ein
Solid Queue-Worker, dessen Tabellen es noch nicht gibt, wartet mit einem Hinweis im Log, bis
rails db:prepare gelaufen ist. Die wiederkehrenden Aufgaben aus config/recurring.yml laufen in
demselben Worker mit, einen zweiten brauchst du dafür nicht. Mehr dazu unter
Worker und Cron-Jobs.
Ruby später dazunehmen oder entfernen
Abschnitt betitelt „Ruby später dazunehmen oder entfernen“Die Ruby-Karte im Bereich Laufzeit hat einen Schalter Ruby aktivieren. Schaltest du ihn aus,
verschwinden der Ruby-Container und die Container der Ruby-Worker; deine Dateien und die
Worker-Definitionen bleiben. Auf der Kommandozeile kennt envoryx dafür --ruby <version>,
--ruby-server und --ruby-preset rails|rack.